DataCube Suite pour une BI fiable : 5 étapes, des sources aux rapports automatisés
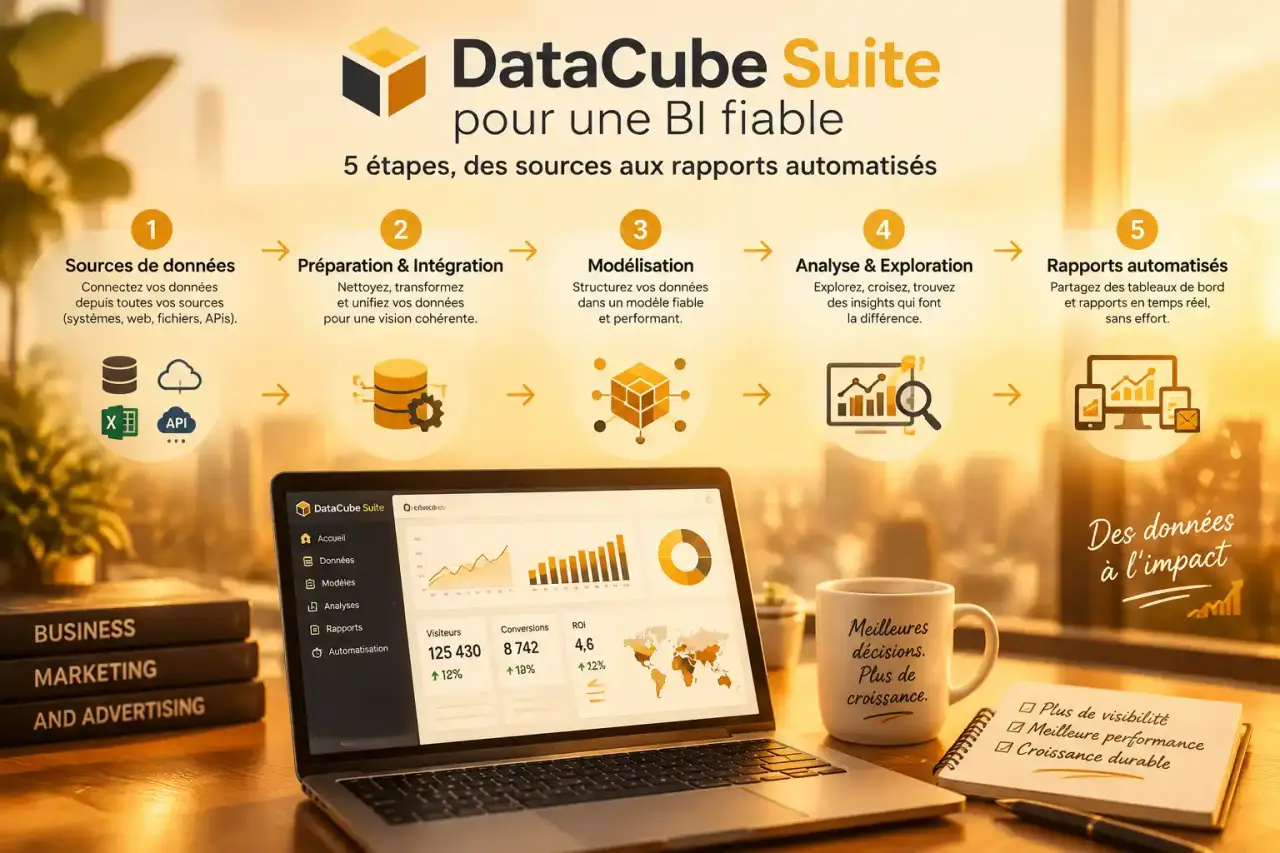
La business intelligence devient utile lorsqu’elle transforme des données dispersées en décisions plus rapides, sans multiplier les exports, les copier-coller ni les versions contradictoires d’un même fichier. Avec DataCube Suite, la démarche consiste à relier les sources existantes, fiabiliser les calculs, puis fournir aux équipes métier des tableaux de bord et des rapports exploitables.
Partir des questions métier avant de connecter les données
Avant d’ouvrir un connecteur, listez les décisions que les utilisateurs doivent réellement prendre. Une direction commerciale peut vouloir suivre le chiffre d’affaires, la marge et le taux de transformation par région. La finance cherchera plutôt les coûts, les écarts budgétaires et les délais de paiement. Cette étape évite de charger des tables inutiles et de créer un tableau de bord spectaculaire, mais peu actionnable.
Définir les KPI et leur règle de calcul
Un KPI fiable ne se limite pas à un intitulé. Il doit préciser son périmètre, sa formule, sa période, son niveau de détail et son responsable métier. Par exemple, une marge peut correspondre au chiffre d’affaires moins le coût d’achat. Il faut toutefois déterminer si les remises, les frais logistiques et les avoirs sont inclus. Centraliser ces définitions limite les débats sur les chiffres et donne à chaque service la même lecture de la performance.
Choisir un périmètre de départ réaliste
Commencez avec trois à quatre sources prioritaires : un ERP, un CRM, une base SQL et, si nécessaire, un fichier Excel ou Google Sheets. Ce périmètre couvre souvent 80 % des questions d’une PME tout en gardant le projet maîtrisable. Il vaut mieux publier un premier tableau de bord simple, validé et évolutif que viser immédiatement une centralisation totale difficile à maintenir.
| Étape | Module concerné | Résultat attendu |
|---|---|---|
| Connexion | DataConnector | Sources accessibles et synchronisées |
| Préparation | DataConnector | Données homogènes et contrôlées |
| Modélisation | Modèle analytique | Dimensions, faits et mesures cohérents |
| Visualisation | VizBuilder | Tableaux de bord filtrables et lisibles |
| Diffusion | ReportScheduler | Exports PDF ou Excel planifiés |
Connecter et préparer les flux dans DataConnector
DataConnector relie DataCube Suite aux sources de données, notamment les ERP, CRM, bases MySQL, PostgreSQL et autres bases SQL, Google Sheets, plateformes publicitaires ou API. La solution annonce plus de 50 connecteurs natifs. Il reste nécessaire de vérifier la compatibilité précise de chaque système, le mode d’authentification et la fréquence de rafraîchissement souhaitée.
Configurer une synchronisation sans surcharger les systèmes
Pour chaque source, choisissez le connecteur, renseignez les accès, testez la connexion et identifiez les tables ou feuilles réellement utiles. Vérifiez ensuite la présence des clés de rapprochement : identifiant client, référence produit, numéro de commande ou date de transaction. Programmez des mises à jour adaptées au besoin. Un suivi hebdomadaire n’exige pas forcément une synchronisation en continu, tandis qu’un suivi opérationnel peut nécessiter des rafraîchissements plus fréquents.
Nettoyer avant de visualiser
Supprimez les doublons, corrigez les valeurs manifestement erronées et harmonisez les dates, les devises, les unités et les libellés. « Île-de-France », « IDF » et « Ile de France » doivent devenir une même valeur si l’analyse régionale doit être juste. Documentez aussi les transformations appliquées. Ce data lineage permet de retrouver l’origine d’un chiffre, la règle qui l’a modifié et son usage dans un rapport.
La fraîcheur d’une donnée impose un équilibre entre réactivité et stabilité. Un rafraîchissement trop fréquent peut multiplier les incidents et les écarts temporaires, tandis qu’un rythme trop lent rend le pilotage moins utile. Pour chaque indicateur, définissez une heure de coupure et affichez la date de dernière mise à jour. Cette information évite de comparer, dans une même réunion, des ventes arrêtées à midi avec des stocks actualisés la veille.
Construire un modèle analytique et comprendre le cube OLAP
Une base OLTP sert aux opérations quotidiennes : enregistrer une commande, modifier une fiche client ou gérer un paiement. Elle n’est pas conçue pour des analyses lourdes et répétées. Un environnement OLAP, à l’inverse, organise les données pour explorer rapidement des volumes historiques, croiser les axes d’analyse et calculer des agrégats sans ralentir les applications de production.
Relier faits, dimensions, mesures et hiérarchies
Le modèle en étoile est un bon point de départ. Au centre, la table de faits contient les événements mesurables, comme les lignes de vente avec la quantité, le chiffre d’affaires et la marge. Autour, les tables de dimensions décrivent le contexte : client, produit, commercial, région ou temps. Les dimensions servent à filtrer et à regrouper les données. Les mesures représentent les valeurs quantitatives, tandis que les hiérarchies permettent de passer de l’année au trimestre, puis au mois et au jour.
Dans un cube OLAP, l’utilisateur peut effectuer un drill-down pour descendre du chiffre d’affaires annuel vers le détail mensuel, ou un drill-up pour revenir à une vue synthétique. Les agrégations précalculées accélèrent cette exploration. Les architectures MOLAP, ROLAP et HOLAP répondent à des besoins distincts : MOLAP privilégie les données multidimensionnelles pré-agrégées, ROLAP s’appuie sur des requêtes relationnelles adaptées aux gros volumes et HOLAP combine les deux approches.
Créer un tableau de bord lisible avec VizBuilder
VizBuilder permet de construire des visualisations par glisser-déposer. Cette facilité ne dispense pas d’une logique éditoriale. Un tableau de bord doit répondre à une question précise, faire ressortir une anomalie ou guider une action. Limitez le nombre d’indicateurs visibles et placez les plus décisifs en tête de page.
Associer chaque visuel à une décision
Utilisez une courbe pour suivre une évolution dans le temps, un histogramme pour comparer des catégories, une carte pour observer une répartition géographique et un tableau détaillé pour contrôler les valeurs. Un tableau commercial peut associer le chiffre d’affaires, la marge, le nombre de commandes et le panier moyen à des filtres par période, région, famille de produits et client. Évitez les camemberts lorsqu’il existe trop de catégories, car ils compliquent la comparaison.
Valider les chiffres avec les futurs utilisateurs
Avant publication, faites tester le tableau de bord par les responsables finance, ventes ou opérations concernés. Comparez les résultats avec les rapports existants, notamment Excel, et expliquez chaque écart : périmètre différent, date de chargement, formule historique ou doublon corrigé. Cette recette est indispensable avant de remplacer un reporting manuel. Elle facilite l’adoption et transforme la solution en outil de self-service BI, plutôt qu’en tableau réservé à l’équipe technique.
Automatiser la diffusion et sécuriser le déploiement
ReportScheduler sert à programmer les exports et les envois de rapports, notamment au format PDF ou Excel. Selon l’usage, les destinataires peuvent recevoir un document chaque jour, chaque semaine ou chaque mois. L’automatisation réduit les tâches répétitives, mais un rapport envoyé régulièrement doit rester pertinent. Définissez les listes de diffusion, les filtres appliqués et le niveau de confidentialité de chaque contenu.
Migrer Excel sans perdre l’historique
Ne remplacez pas tous les fichiers d’un coup. Inventoriez les onglets, les formules, les tableaux croisés, les macros, les règles de calcul et les périodes d’historique. Reproduisez d’abord les rapports les plus utilisés, puis comparez les totaux sur plusieurs périodes. Conservez les fichiers d’origine pendant la transition pour pouvoir analyser les écarts. Excel reste utile pour des analyses ponctuelles, tandis que DataCube Suite centralise les calculs récurrents et la diffusion partagée.
Mettre en place des contrôles simples et continus
Avant le déploiement, vérifiez les accès réseau, les droits utilisateurs, la disponibilité des sources et la qualité des flux. Désignez un propriétaire pour chaque indicateur, un administrateur pour les connexions et un processus de correction en cas d’échec de synchronisation. Contrôlez régulièrement la complétude des données, les champs manquants et les écarts avec les systèmes source. Cette gouvernance des données aide à maintenir un tableau de bord consulté et fiable dans la durée.